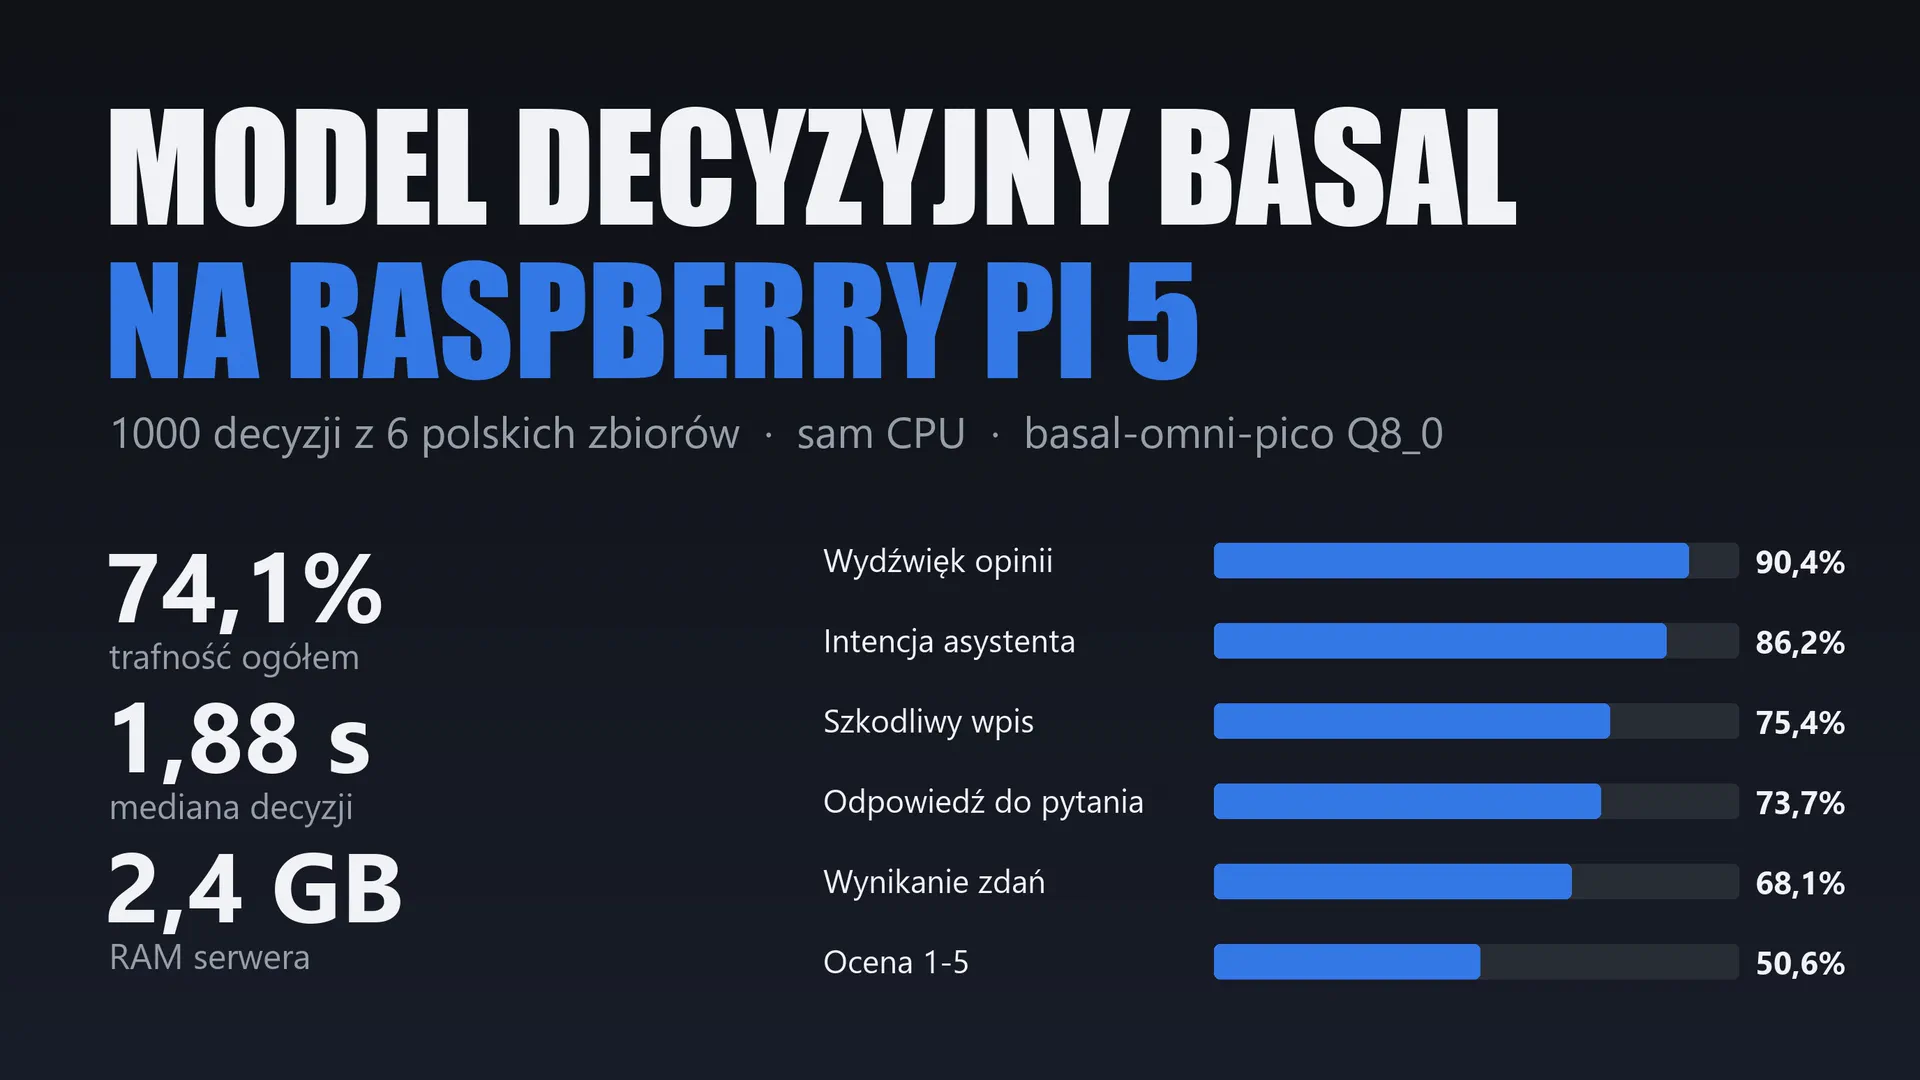
Postawiłem model decyzyjny basal-omni-pico w kwantyzacji Q8_0 na Raspberry Pi 5 z 8 GB RAM, bez karty graficznej i bez chmury, i przepuściłem przez niego 1000 decyzji z sześciu polskich zbiorów testowych. Wynik z 24 października 2026: trafność 74,1%, mediana 1,88 s na decyzję, 2,4 GB RAM i procesor, który nie doszedł do dławienia. Najciekawsze nie jest jednak samo 74%, tylko to, że model wie, kiedy nie wie.
Największy plus całego rozwiązania to jednak miejsce, w którym działa. Raspberry Pi jest energooszczędne, bierze bardzo mało prądu i może pracować bez przerwy, a karta graficzna zostaje wolna na cięższe zadania.
Dlaczego Raspberry Pi, a nie karta graficzna
Bo decyzje mają się dziać cały czas, a nie tylko wtedy, gdy włączę mocny komputer. To najważniejszy wniosek z tego testu, ważniejszy niż sama trafność.
- Mało prądu. Raspberry Pi 5 pracuje na zasilaczu USB-C i nawet pod pełnym obciążeniem pobiera kilka watów. Karta graficzna z komputerem, na którym stoi, bierze wielokrotnie więcej już na biegu jałowym.
- Może być włączone ciągle. Malinka chodzi 24/7 cicho, mieści się w dłoni i nie generuje rachunku, który boli. Model decyzyjny jest wtedy po prostu usługą w sieci domowej albo firmowej, zawsze pod ręką dla N8N, Home Assistanta czy skryptu.
- GPU zostaje wolne. Klasyfikacja zgłoszenia czy intencji to proste zadanie i szkoda na nie karty graficznej. Ta może w tym czasie robić rzeczy, których Pi nie udźwignie: większe modele językowe, OCR, transkrypcję, generowanie obrazów.
Podział jest prosty: lekkie, ciągłe decyzje na Raspberry Pi, ciężkie przetwarzanie na GPU. Pi odsiewa, kieruje i rozpoznaje intencje, a do karty graficznej trafia tylko to, co naprawdę wymaga jej mocy.
Czym jest model decyzyjny i czym różni się od czatu
Model decyzyjny nie pisze odpowiedzi, tylko wybiera z zamkniętej listy i podaje prawdopodobieństwo każdej opcji. Pytasz "do którego działu trafia to zgłoszenie", dajesz trzy działy, dostajesz online z pewnością 0,998 i rozkład na pozostałe dwa.
basal obsługuje cztery typy pytań, wszystkie przetestowane w tym przebiegu:
- choice - jedna opcja z listy (intencja, dział, wydźwięk),
- noul - tak/nie z prawdopodobieństwem "tak" (phishing, zgodność z regulaminem),
- score - poziom na skali z legendą, plus średnia ważona (ocena 1-5),
- multi - kilka opcji naraz z progiem 0,5 (zgłoszenie z dwoma problemami).
Dla automatyzacji to wygodniejszy kształt niż czat: odpowiedź od razu da się wpiąć w if, a liczba przy niej mówi, czy w ogóle warto ją wpinać.
Stanowisko testowe
| Element | Wartość |
|---|---|
| urządzenie | Raspberry Pi 5 Model B Rev 1.1 |
| system | Linux 6.12.34+rpt-rpi-2712, aarch64 |
| procesor | 4 rdzenie, sam CPU |
| RAM | 8 GB, serwer basala zajmuje 2,4 GB |
| model | basal-omni-pico, GGUF Q8_0, serwer basal 2.4.1 |
| tryb | jedno zapytanie naraz, czas mierzony po stronie serwera |
Czas to czas serwera na Pi, bez sieci. Klient stał na innej maszynie, temperatura była odczytywana przez SSH co 20 decyzji.
Rozgrzewka: 9 scenariuszy z życia
Zanim poszedł pełny test, sprawdziłem, czy model w ogóle rozumie polskie polecenia w każdym typie pytania. Dziewięć scenariuszy, 9 na 9 zaliczonych.
| Scenariusz | Odpowiedź modelu | Czas | Tokeny |
|---|---|---|---|
| Bank: routing zgłoszenia | dział: online (1,00), pilne: tak 0,77 | 1,77 s | 232 |
| Inteligentny dom: intencja | light (1,00) | 0,85 s | 111 |
| Phishing w SMS-ie | oszustwo: tak 0,96 | 0,81 s | 107 |
| Opinia negatywna | poziom 0, średnio 0,17 | 1,09 s | 130 |
| Opinia pozytywna | poziom 4, średnio 3,89 | 0,93 s | 123 |
| Kilka problemów naraz | billing, delay | 2,65 s | 354 |
| Zgodność z regulaminem | zgodny: tak 0,20 | 0,88 s | 110 |
| English: customer intent | refund (1,00) | 0,76 s | 100 |
| Czujnik (stan w JSON) | alarm (0,76) | 1,19 s | 151 |
Krótkie pytanie powtórzone 20 razy: mediana 847 ms, p95 895 ms, rozrzut 844-902 ms, czyli 1,17 decyzji na sekundę. Pi trzyma czas bardzo równo.
Wyniki na 1000 decyzjach
Sześć zbiorów, po około 167 losowych przykładów z każdego (ziarno 42). Kolumna "zgadywanie" to wynik, jaki dałoby wybieranie zawsze najczęstszej klasy w tej próbce - punkt odniesienia, poniżej którego model nic nie wnosi.
| Zbiór | Typ | Trafność | 95% CI | Zgadywanie | Mediana |
|---|---|---|---|---|---|
| Wydźwięk opinii (PolEmo 2.0-IN) - najlepszy wynik | choice, 4 klasy | 90,4% | 85%-94% | 45% | 2,76 s |
| Intencja asystenta głosowego (MASSIVE pl) | choice, 18 dziedzin | 86,2% | 80%-91% | 13% | 3,14 s |
| Szkodliwy wpis (CBD) | noul, po równo | 75,4% | 68%-81% | 50% | 0,99 s |
| Czy odpowiedź pasuje do pytania (DYK) | noul, po równo | 73,7% | 66%-80% | 50% | 1,47 s |
| Wynikanie między zdaniami (CDSC-E) | choice, 3 klasy | 68,1% | 61%-75% | 34% | 1,40 s |
| Ocena gwiazdkowa 1-5 (Allegro Reviews) | score | 50,6% | 43%-58% | 39% | 2,19 s |
Wydźwięk i intencja to zadania, które ten model robi dobrze - przy intencji skok z 13% zgadywania do 86% jest największy w całym teście. Ocena gwiazdkowa wygląda słabo tylko na pierwszy rzut oka: dokładną liczbę gwiazdek model trafia w 50,6% przypadków, ale z dokładnością do jednej gwiazdki w 87%, ze średnim błędem 0,83. Pomylenie czwórki z piątką rzadko ma znaczenie biznesowe.
Najtrudniejsze okazało się wynikanie między zdaniami (CDSC-E), gdzie trzeba ocenić relację logiczną dwóch zdań. To zadanie dla większych modeli niż wersja pico.
Pewność, której da się zaufać
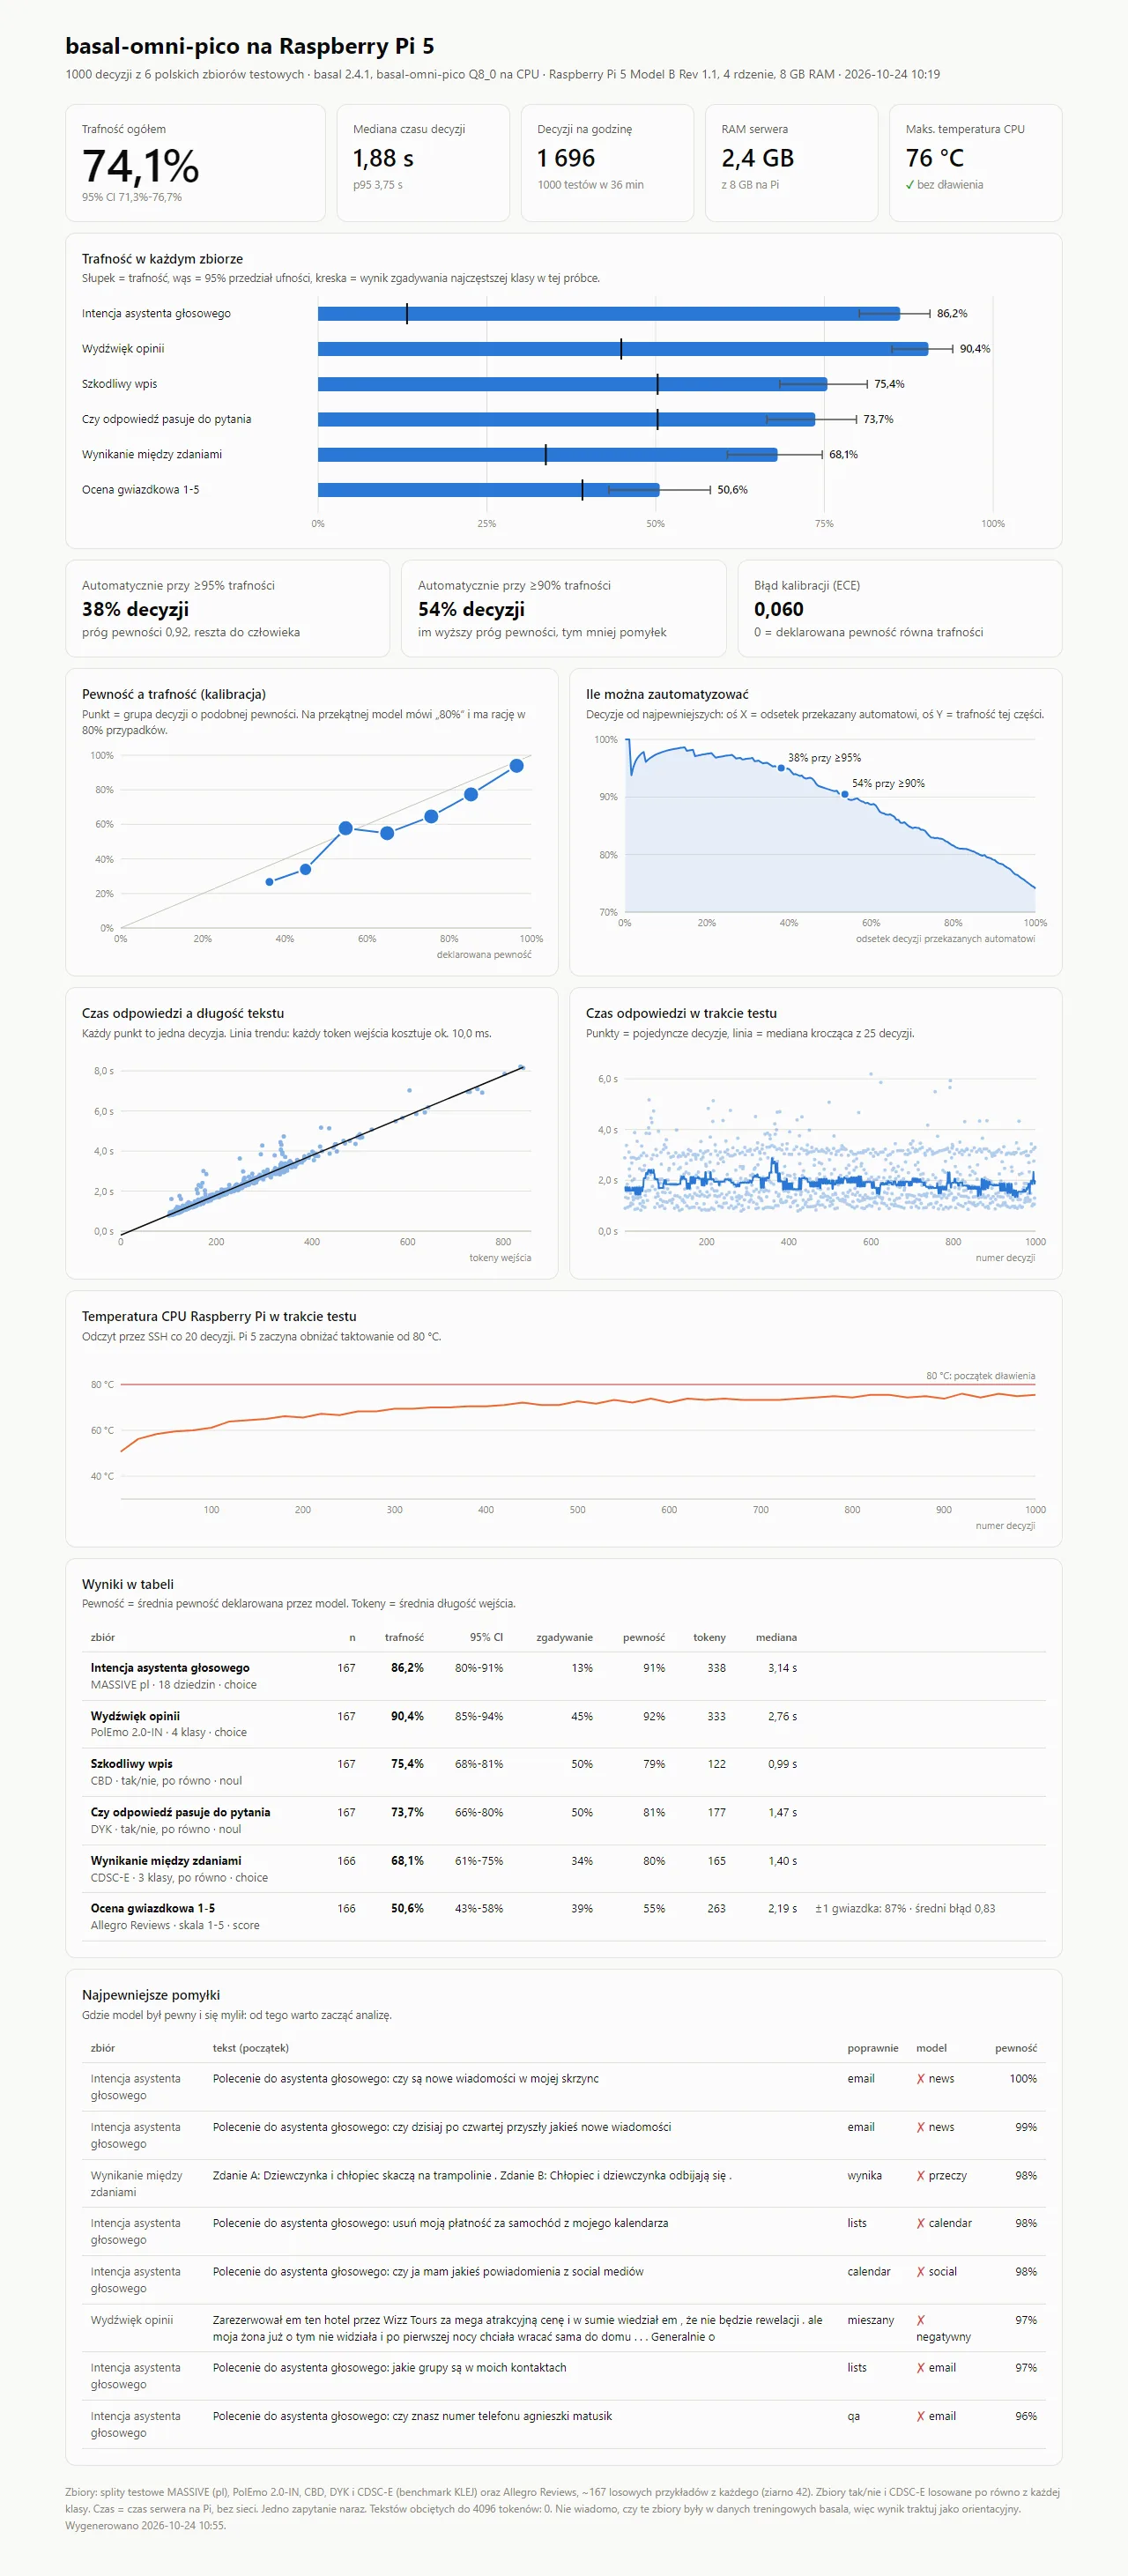
To jest powód, dla którego ten test w ogóle piszę. Błąd kalibracji (ECE) wyszedł 0,060 - kiedy model deklaruje 80% pewności, ma rację mniej więcej w 80% przypadków. Przy takiej kalibracji liczba przy odpowiedzi przestaje być ozdobą i staje się progiem do automatyzacji:
- przy progu pewności 0,92 38% decyzji idzie automatem z trafnością 95%,
- przy niższym progu 54% decyzji idzie automatem z trafnością 90%,
- reszta trafia do człowieka.
W praktyce to wzorzec "automat bierze pewne, człowiek resztę". Zamiast pytać, czy model ma 74% czy 90%, ustawiasz próg pod akceptowalny poziom pomyłek i dostajesz odpowiedź, ile ręcznej pracy znika.
Skąd biorą się pomyłki
Najpewniejsze błędy są pouczające. Sześć z ośmiu dotyczy intencji asystenta głosowego i większość to pomyłki na granicy kategorii, a nie absurdy:
| Polecenie | Poprawnie | Model | Pewność |
|---|---|---|---|
| czy są nowe wiadomości w mojej skrzynce | news | 100% | |
| usuń moją płatność za samochód z mojego kalendarza | lists | calendar | 98% |
| czy ja mam jakieś powiadomienia z social mediów | calendar | social | 98% |
| jakie grupy są w moich kontaktach | lists | 97% |
"Wiadomości" jako newsy zamiast poczty, "kalendarz" jako kalendarz, choć etykieta mówi o liście. Część z tych przykładów człowiek też by zakwestionował. To dobre miejsce na start, jeśli chcesz dopisać opis kategorii w pytaniu do modelu.
Czas i temperatura
Czas decyzji rośnie liniowo z długością tekstu: każdy token wejścia kosztuje około 10 ms. Krótkie zgłoszenie (100 tokenów) to niecała sekunda, długa opinia (800 tokenów) to około 8 sekund. Zbiory z dłuższymi tekstami - intencja (średnio 338 tokenów) i wydźwięk (333) - mają najwyższą medianę, choć same zadania nie są trudniejsze.
Temperatura CPU wzrosła z około 50 °C do 76 °C i ustabilizowała się po około 400 decyzjach. Raspberry Pi 5 zaczyna obniżać taktowanie od 80 °C, więc przez 36 minut ciągłej pracy nie doszło do dławienia, a mediana krocząca czasu nie rosła z upływem testu. Przy pracy 24/7 w zamkniętej obudowie zapas 4 °C to mało - aktywne chłodzenie warto mieć.
Pełny raport
Do czego to się nadaje
Raspberry Pi 5 z basal-omni-pico to 1 696 decyzji na godzinę lokalnie, bez abonamentu, bez wysyłania tekstu na zewnątrz i na urządzeniu, które bierze kilka watów i może pracować bez przerwy. Sensowne zastosowania to te, gdzie tekst jest krótki, a pomyłkę da się wyłapać progiem pewności:
- routing zgłoszeń i maili do działu,
- intencje poleceń w inteligentnym domu,
- wstępny filtr phishingu i szkodliwych treści,
- wydźwięk opinii klientów,
- decyzje na podstawie stanu czujnika podanego jako JSON.
Słabiej wypada przy długich tekstach (czas) i przy zadaniach wymagających rozumowania logicznego (CDSC-E).
Zastrzeżenia
Zbiory to splity testowe MASSIVE (pl), PolEmo 2.0-IN, CBD, DYK i CDSC-E z benchmarku KLEJ oraz Allegro Reviews. Zbiory tak/nie i CDSC-E losowane po równo z każdej klasy. Żaden tekst nie został obcięty (limit 4096 tokenów). Nie wiadomo, czy te zbiory były w danych treningowych basala, więc wyniki traktuj jako orientacyjne. Na własnych danych zmierz przed wdrożeniem - to kilkadziesiąt minut pracy Pi.