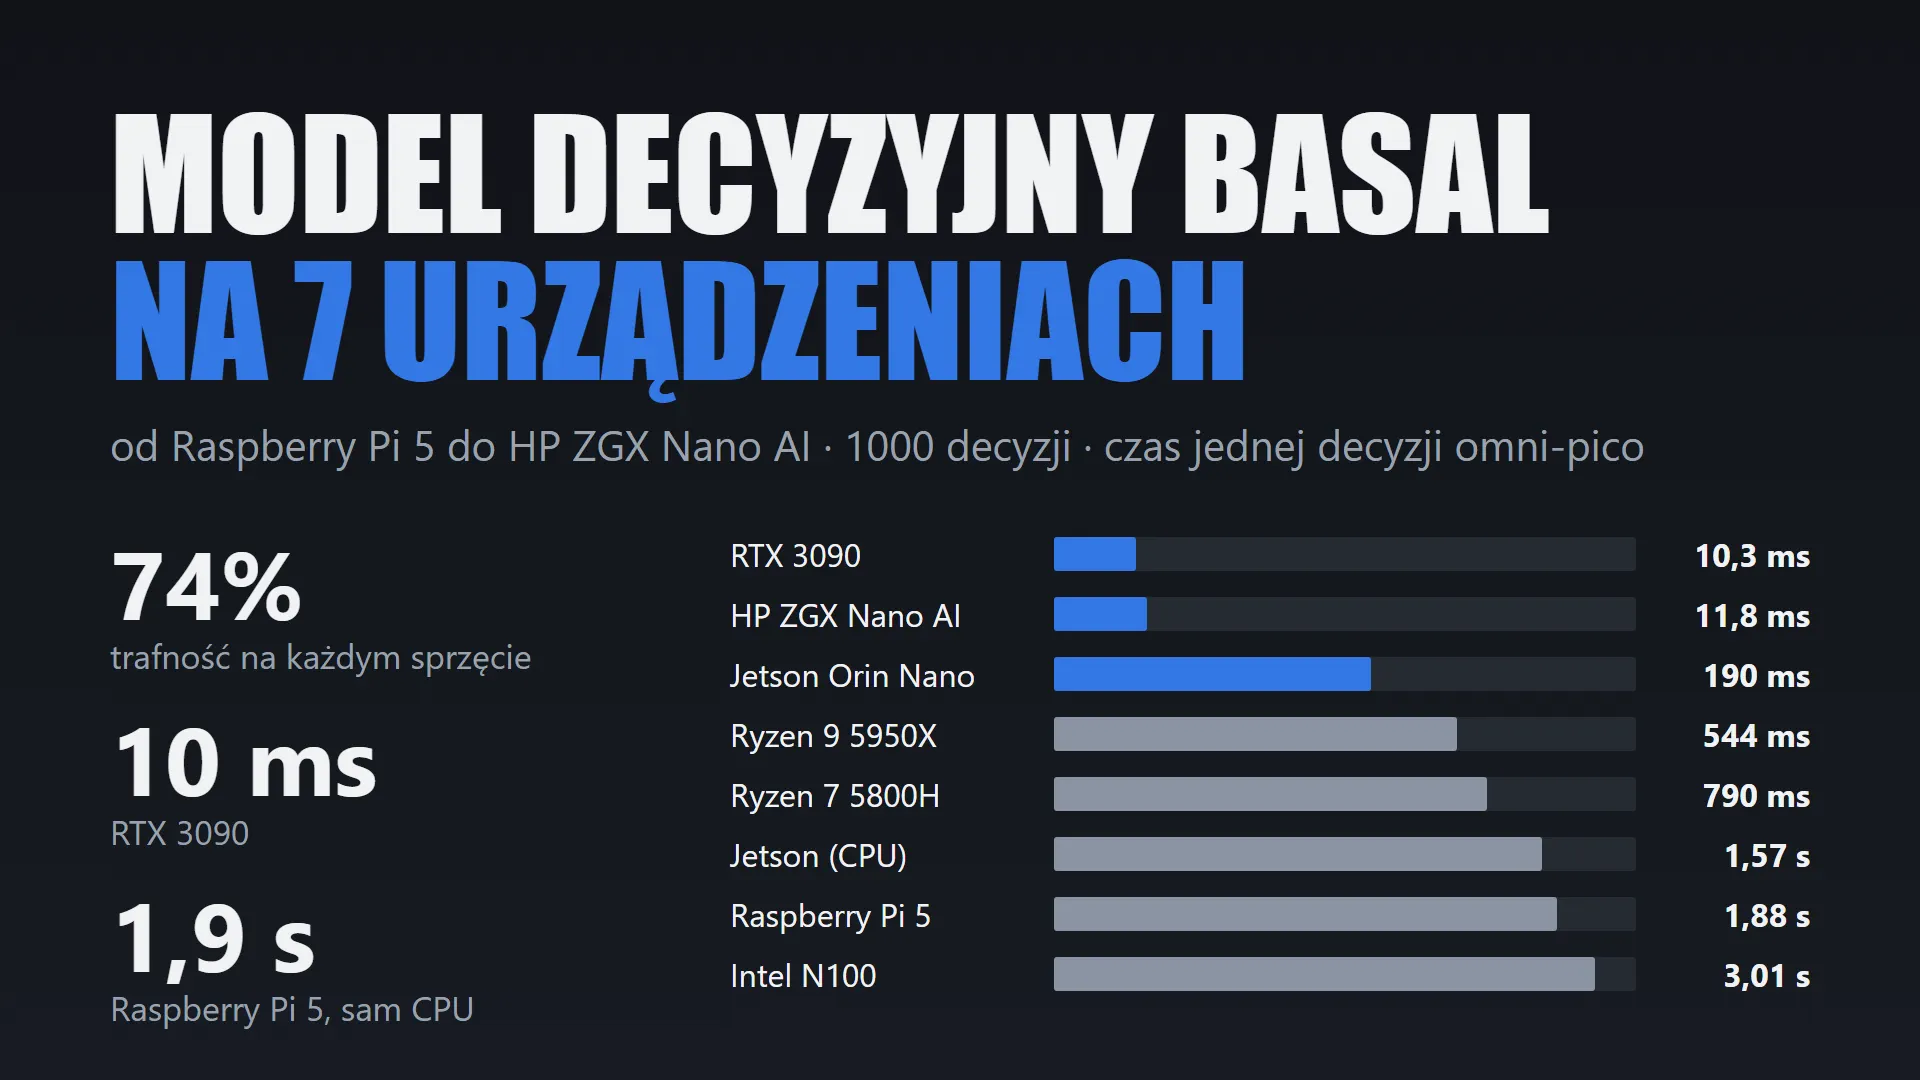
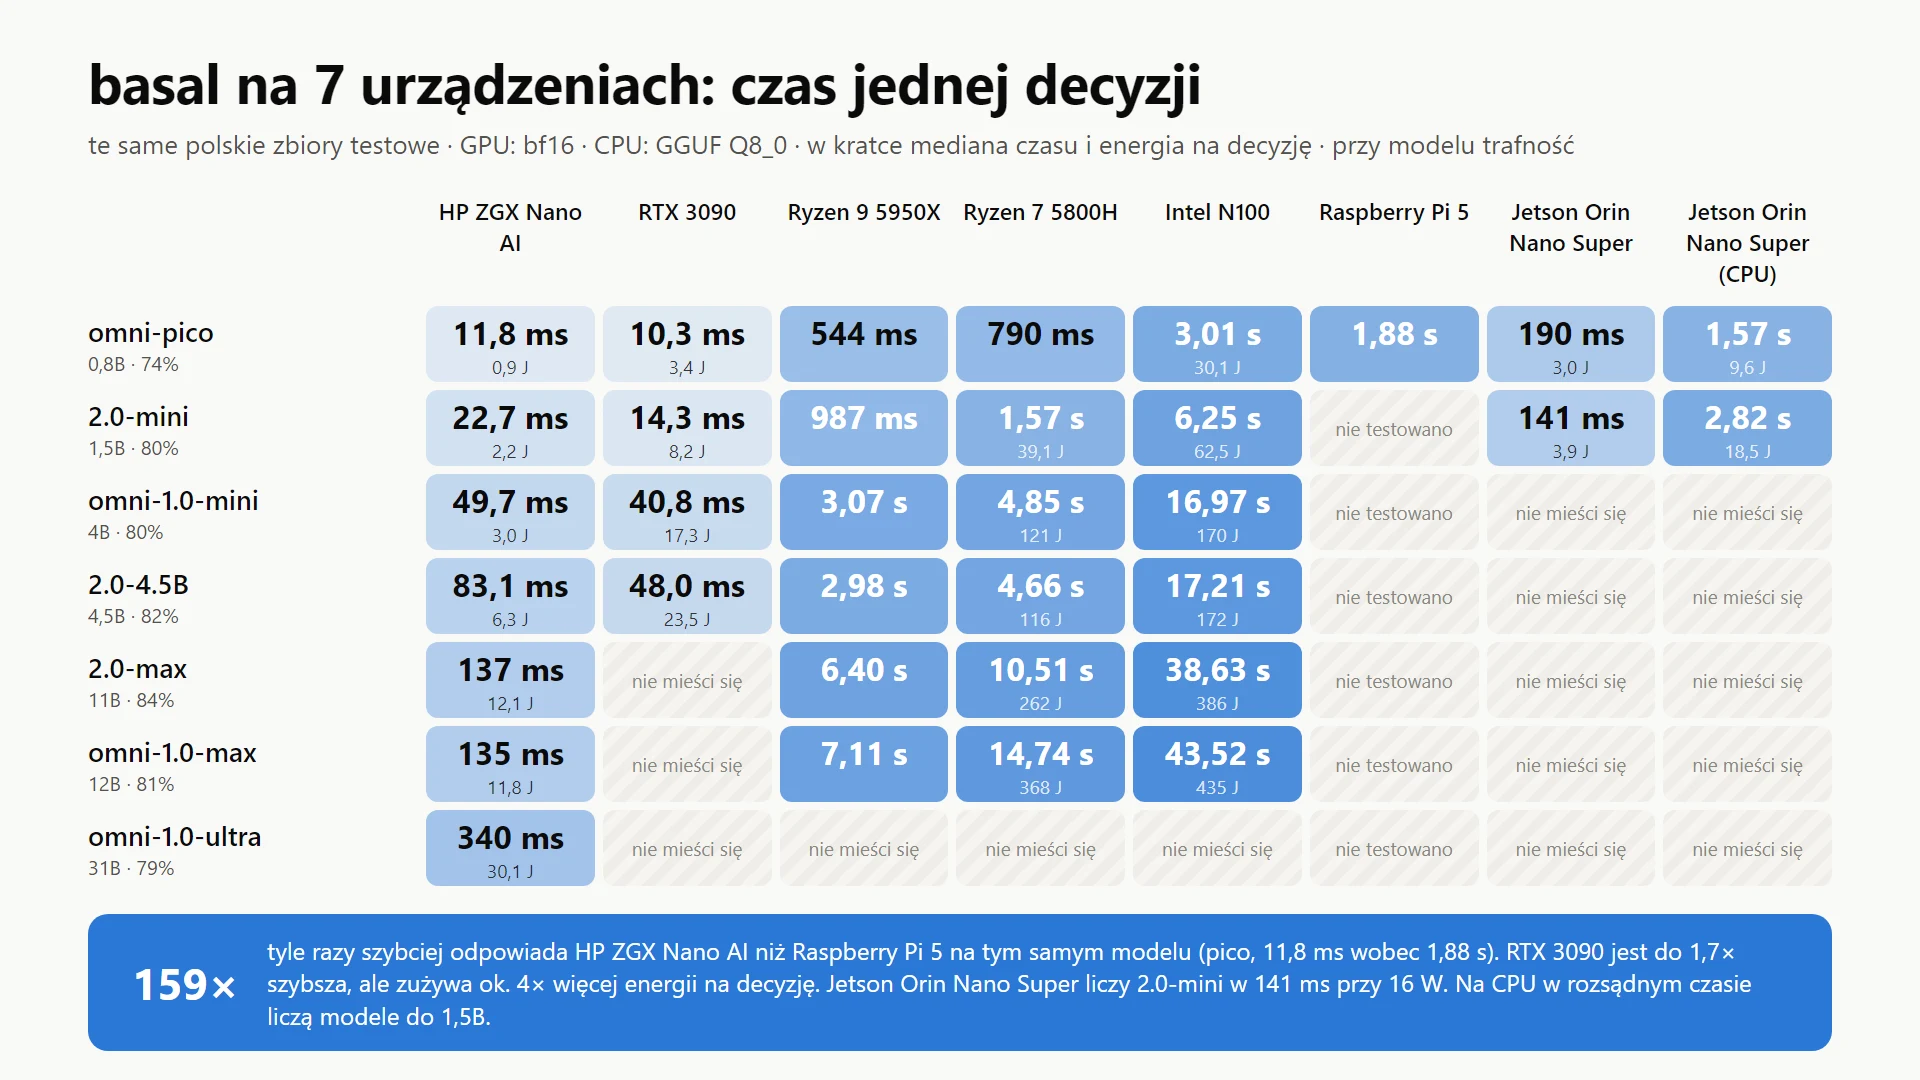
Uruchomiłem tę samą wersję basala (2.4.1) na siedmiu urządzeniach: od Raspberry Pi 5 bez karty graficznej po HP ZGX Nano AI. Na każdym z nich model odpowiadał na te same 1000 pytań z polskich zbiorów testowych. Najmniejszy model, omni-pico, trafił w 74,0-74,4% przypadków na każdym sprzęcie. Jedna decyzja trwała od 10 ms na RTX 3090 do 3 s na Intelu N100.
Ten test pokazuje możliwości, nie rekomenduje sprzętu. Chciałem sprawdzić, co da się uruchomić i z jakim efektem. To, który sprzęt będzie dla Ciebie właściwy, zależy od ruchu, budżetu i tego, co już masz w szafie. Raspberry Pi 5 trafiło na listę z prostego powodu: mam je od dawna. Przy okazji wyszło, jak dobrze basal radzi sobie na tak małej płytce.
Czym jest basal i co tu mierzyłem?
basal to polski model decyzyjny. Dostaje tekst i zamknięte pytanie: wybór jednej z opcji, tak lub nie albo ocenę na skali. Zwraca odpowiedź razem z pewnością. Nie pisze tekstu, tylko decyduje, więc nadaje się do routingu zgłoszeń, filtrowania wpisów albo rozpoznawania intencji w inteligentnym domu. Szerzej opisałem to we wpisie o basalu na Raspberry Pi 5.
Zestaw testowy to 1000 decyzji z 6 polskich zbiorów: MASSIVE pl (dziedzina polecenia dla asystenta), PolEmo 2.0-IN (wydźwięk opinii), CBD (szkodliwe wpisy), DYK (czy odpowiedź pasuje do pytania), CDSC-E (wynikanie między zdaniami) i Allegro Reviews (ocena 1-5 gwiazdek). Zestaw jest stały (ziarno 42), więc wyniki z różnych urządzeń da się porównać 1:1.
| urządzenie | jak liczył basal | pamięć dla modelu |
|---|---|---|
| HP ZGX Nano AI (GB10) | GPU, bf16 | 128 GB wspólnej |
| RTX 3090 | GPU, bf16 | 24 GB VRAM |
| Jetson Orin Nano Super (tryb 25 W) | GPU bf16 albo CPU GGUF Q8_0 | 7,3 GB wspólnej |
| Ryzen 9 5950X (WSL, 16 wątków) | CPU, GGUF Q8_0 | 24 GB |
| Ryzen 7 5800H (mini PC) | CPU, GGUF Q8_0 | ok. 15 GB |
| Intel N100 (mini PC) | CPU, GGUF Q8_0 | ok. 14 GB |
| Raspberry Pi 5, 8 GB | CPU, GGUF Q8_0 | 8 GB |
Siedem urządzeń, od małej płytki po stację z GPU. Na każdym liczył ten sam program.
Czas to mediana czasu serwera przy jednym zapytaniu naraz. Energię liczyłem z poboru mocy w trakcie testu: na GPU z nvidia-smi, na procesorach Intel i AMD z liczników RAPL, na Jetsonie z czujnika całej płytki. Na CPU każdy model miał limit 45 minut, więc duże modele zrobiły tam od 52 do 789 decyzji zamiast 1000.
Czy słabszy sprzęt daje gorsze odpowiedzi?
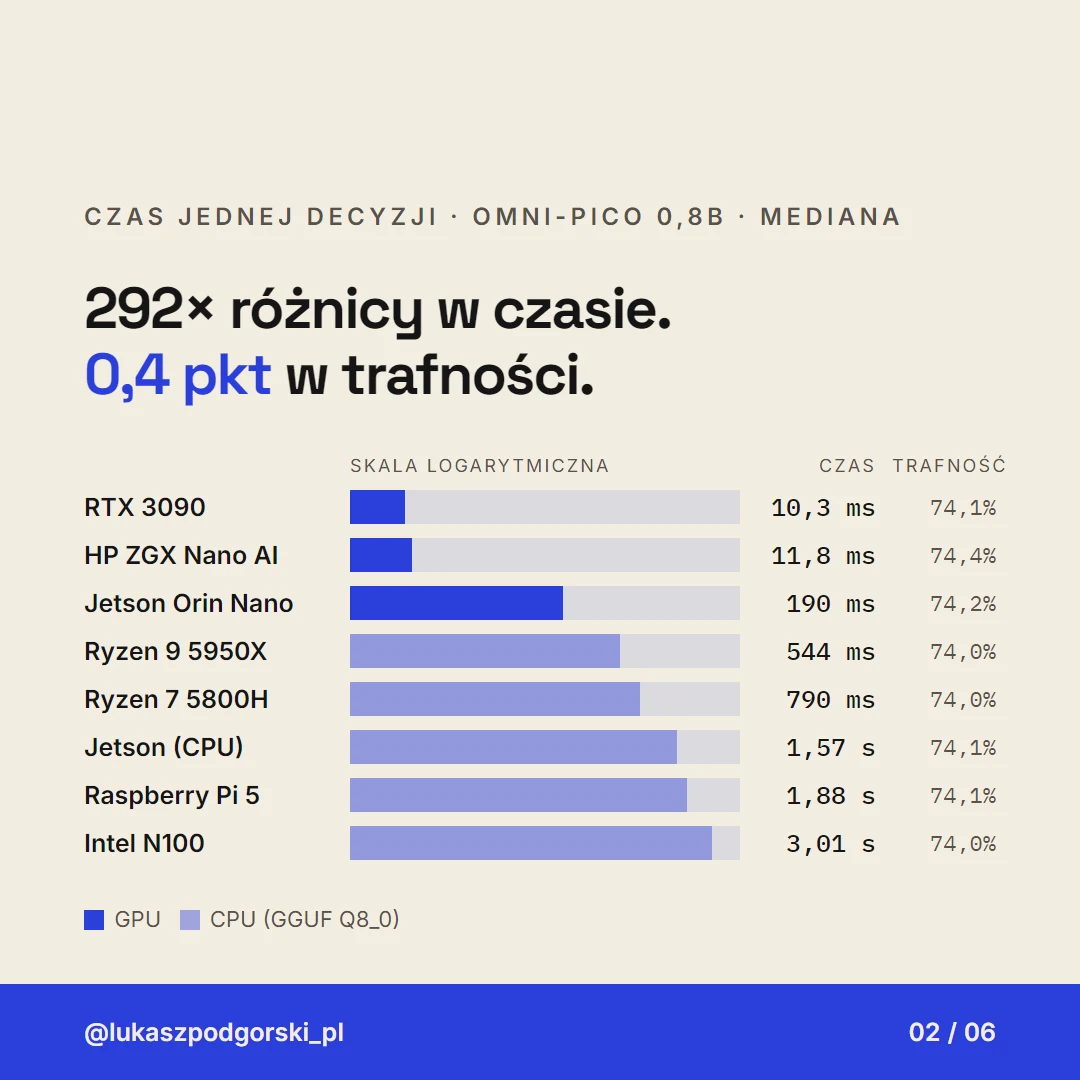
Nie. Ten sam model daje tę samą trafność na każdym urządzeniu. omni-pico trafia 74,0-74,4%, 2.0-mini 79,5-80,1%. Kwantyzacja GGUF Q8_0 na procesorze nie obniża trafności względem bf16 na GPU. Różnice mieszczą się w przedziale ufności.
Ile szybciej liczy karta graficzna?
GPU liczy 50-320 razy szybciej od CPU. omni-pico odpowiada w 10-12 ms na RTX 3090 i HP ZGX Nano AI, w 190 ms na GPU Jetsona, w 0,5-0,8 s na Ryzenach i w 1,9-3 s na Raspberry Pi i N100.
Dwie obserwacje, których się nie spodziewałem:
- RTX 3090 jest szybsza od HP ZGX Nano AI przy jednym zapytaniu. Dla 2.0-4.5B to 48 ms wobec 83 ms. Przy wielu równoległych klientach przepustowość obu jest podobna (14 i 13 decyzji na sekundę).
- Intel N100 jest wolniejszy od Raspberry Pi 5. 3,0 s wobec 1,9 s na tym samym modelu.
Co zmieści się na jakim sprzęcie?
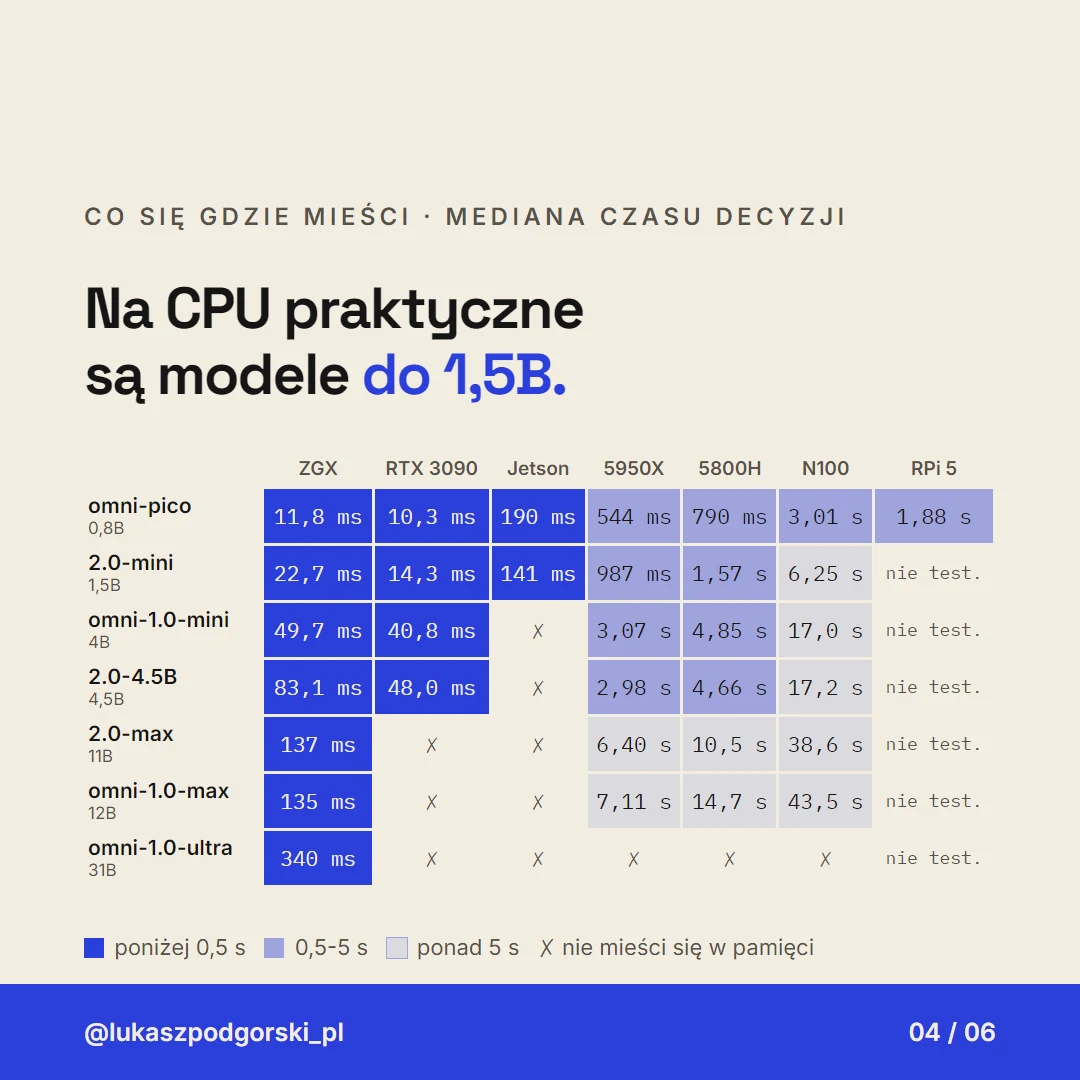
Na procesorze praktyczne są modele do 1,5B. 2.0-mini na Ryzenach liczy 1,0-1,6 s na decyzję przy trafności 80%. Modele 11-12B liczą na CPU od 6 do 44 s na decyzję, więc nadają się tylko do przetwarzania wsadowego, na przykład w nocy.
Które urządzenie zużywa najmniej energii na decyzję?
HP ZGX Nano AI. Na 2.0-mini zużywa 2,2 J na decyzję, RTX 3090 8,2 J, a Intel N100 62,5 J. ZGX pobiera pod obciążeniem 62-81 W, czyli 4 razy mniej niż RTX 3090 (300-330 W), a liczy podobnie szybko.
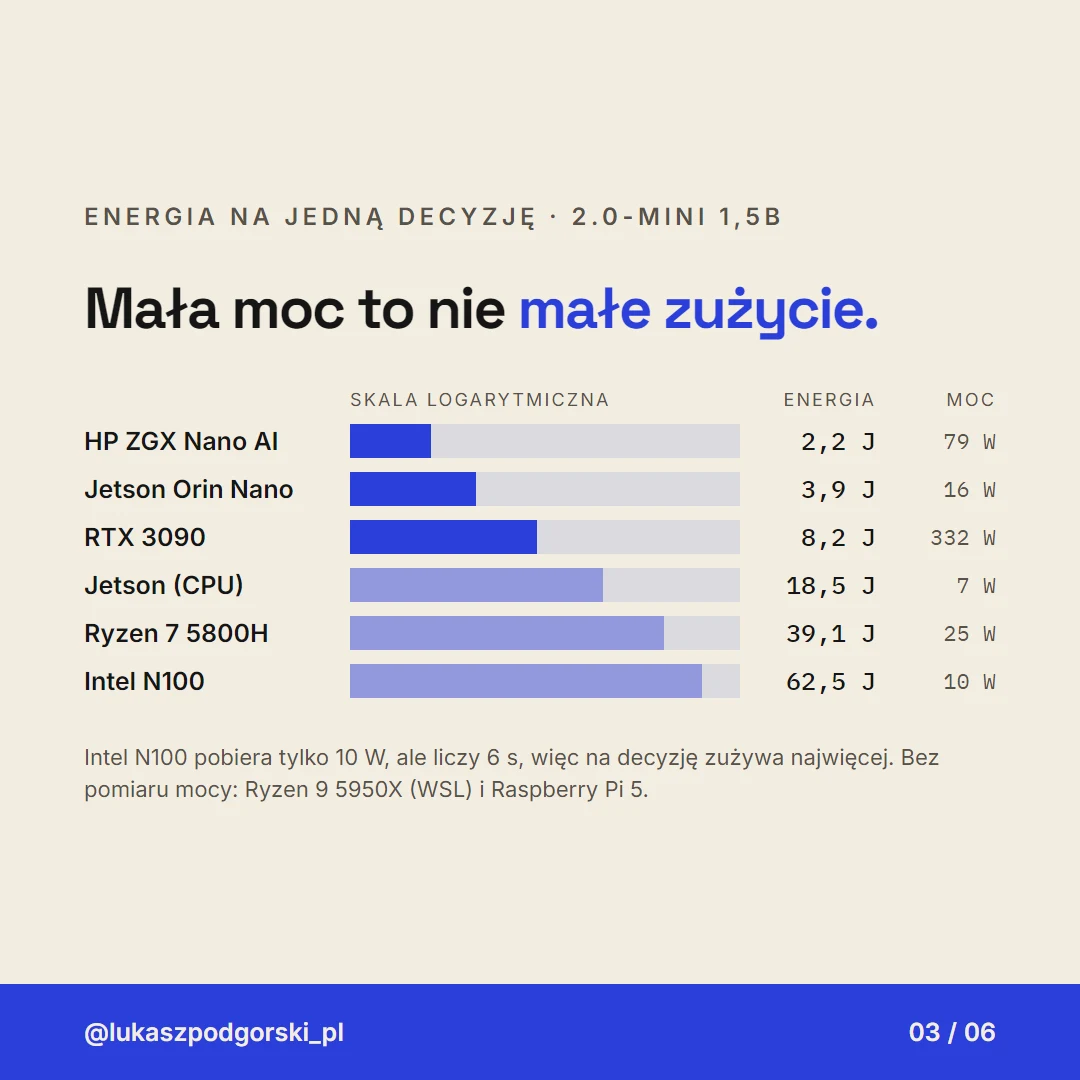
Jetson Orin Nano Super zużywa na GPU 3-4 J na decyzję, tyle co RTX 3090, przy 15-18 W na całą płytkę. Na tej płytce działa tylko najprostszy tryb liczenia (--mode eager). Szybsze tryby wyczerpują 7,3 GB pamięci i zawieszają system.
Jak basal radzi sobie na Raspberry Pi 5?
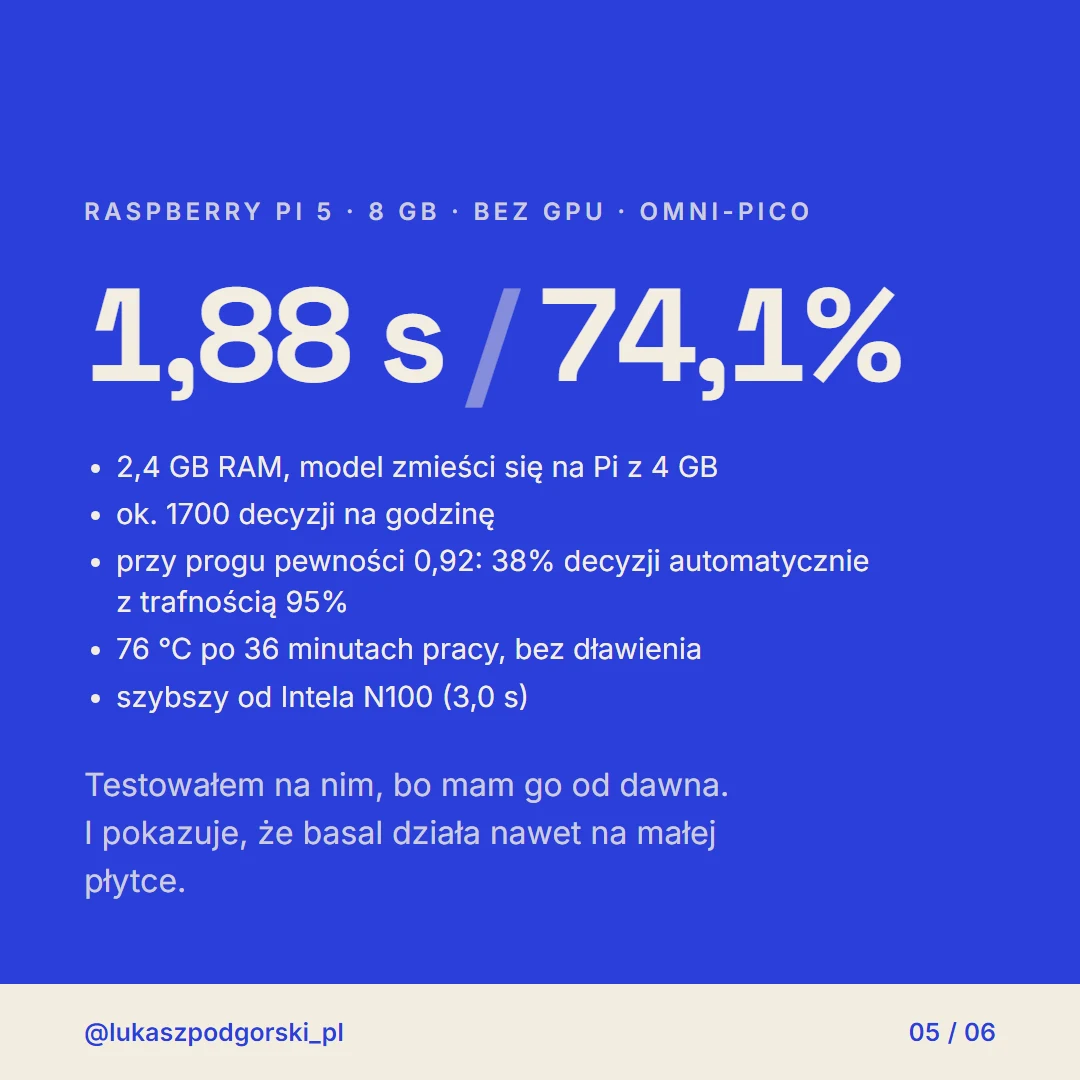
Lepiej, niż się spodziewałem. omni-pico na Raspberry Pi 5 z 8 GB RAM, bez karty graficznej:
- 1,88 s na decyzję i 74,1% trafności, tyle co na GPU,
- 2,4 GB RAM, więc model zmieści się też na Pi z 4 GB,
- ok. 1700 decyzji na godzinę,
- przy progu pewności 0,92 model sam załatwia 38% decyzji z trafnością 95%, a resztę można przekazać człowiekowi,
- po 36 minutach ciągłej pracy procesor miał 76 °C, bez dławienia. Do pracy całodobowej warto dodać wiatrak.
Takie Pi wystarczy do klasyfikacji krótkich tekstów na brzegu sieci: intencji poleceń w domu, wstępnej selekcji zgłoszeń czy filtrowania wiadomości. Nie nadaje się do długich dokumentów w czasie rzeczywistym, bo każdy token wejścia kosztuje ok. 10 ms, ani do wielu zapytań naraz.
Co z tego wynika?
- Trafność zależy od modelu, nie od sprzętu. Wybierając sprzęt, wybierasz czas odpowiedzi i rachunek za prąd, a nie jakość decyzji.
- GPU daje 50-320 razy krótszy czas. Ma to znaczenie przy decyzjach w czasie rzeczywistym i dużym ruchu.
- Na zwykłym procesorze rozsądne są pico i 2.0-mini: 1-3 s na decyzję przy trafności 74-80%. Większe modele na CPU tylko w trybie wsadowym.
- Do pojedynczego urządzenia brzegowego wystarczy Jetson albo Raspberry Pi. Jetson daje 2.0-mini w 0,14 s, a Pi daje pico w 1,9 s.
Czego ten test nie mówi?
- Nie mówi, co kupić. To pokaz możliwości na sprzęcie, który akurat mam, a nie przegląd rynku. Brakuje w nim choćby Apple Silicon, nowszych kart graficznych i procesorów serwerowych.
- Nie wiadomo, czy zbiory testowe były w danych treningowych basala. Liczby traktuj jako orientacyjne, a przed wdrożeniem sprawdź model na własnych danych.
- Na CPU duże modele mają niepełną próbę. Przy 52-60 decyzjach przedział ufności to ok. ±10 punktów. Wiarygodne porównanie trafności między modelami daje kolumna HP ZGX Nano AI, gdzie każdy model zrobił pełne 1000 decyzji.
- Ryzen 9 5950X liczył w WSL i bez pomiaru mocy, a RTX 3090 dzieliła stację z innymi programami. Na natywnym Linuksie wyniki byłyby nieco lepsze.
- Jetson pracował na granicy zasilania. Zabezpieczenie nadprądowe stale spowalniało płytkę, więc jego wyniki są dolną granicą.